目录
  1. 1. P-PCA
    1. 1.1. 数据生成背景
    2. 1.2. 算法理论部分
    3. 1.3. EM算法
      1. 1.3.1. Likelihood
      2. 1.3.2. Joint Likelihood
      3. 1.3.3. E步:
      4. 1.3.4. M步:固定后验概率,即充分统计量固定(看作常数)
P-PCA

P-PCA

数据生成背景

根据白板推导我们已经知道,高斯混合模型有两种理解方式:几何角度**(非概率版本)和生成角度(概率版本)**。

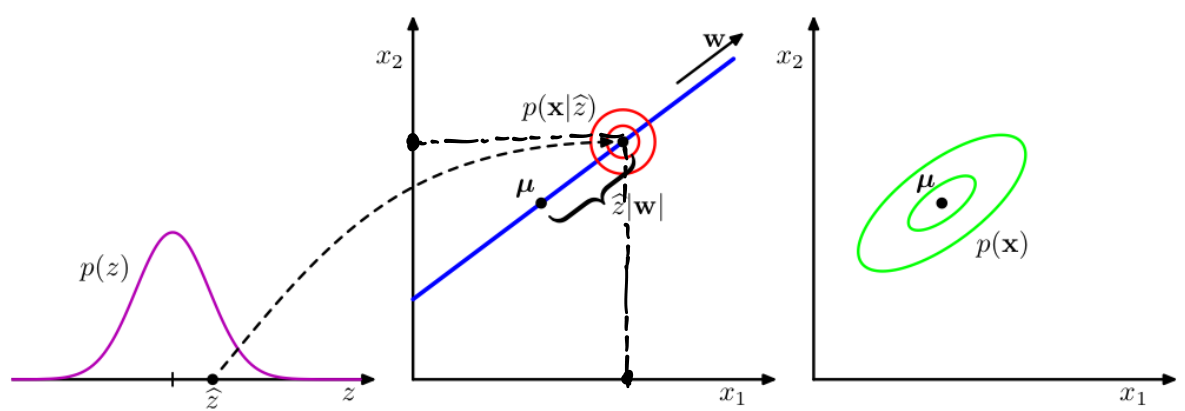
模型的生成方式是:先选定一个高斯分布,再根据这个高斯分布的PDF生成数据点。所以高斯混合模型默认隐变量是离散的。而P-PCA隐变量是均值为0,方差为1的高斯分布。

概率版本与非概率版本的区别在于隐变量的分布

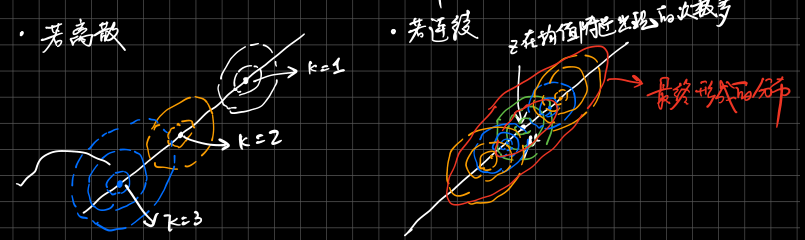
  • 原先的隐变量为离散 --> 连续性(满足某个概率分布)

隐变量的分布情况

上图中左部分是传统的GMM模型,把三个独立的高斯分布根据权重拟合成一个混合的高斯分布。而右图中有无穷多个高斯分布,若选择zz均值附近被选中的概率非常高,所以拟合出的分布这里会非常高。

算法理论部分

已知: p(x)p(x) p(x∣z)p(x|z) p(z)p(z)

  • 隐变量服从零均值单位协方差p(z)∼N(z∣0,I)p(z) \sim \N(z|0,I)

  • 观测变量xx的生成方式:x=Wz+μ+εx = Wz + \mu + \varepsilon

    数据生成方式
  • p(x∣z)∼N(Wz+μ,σ2⋅I)p(x|z) \sim \N(Wz+\mu,\sigma^2\cdot I)

  • p(x)p(x)也是高斯分布,原因在于:p(x)=∫zp(x∣z)p(z)dzp(x) = \int_zp(x|z)p(z)dz

推导xx的PDF:

x∼N(x∣μ,WWT+σ2I)x \sim N(x|\mu,WW^T+\sigma^2I)

分析:

E[x]=E[Wz+μ+ε]=μcov[x]=E[(x−E[x])(x−E[x])T]=E[(Wz+ε)(Wz+ε)T]=E[WzzTWT+εzTWT+WzεT+εεT]=WIWT⋅D(z)+D(ε)=WWT+σ2I\begin{aligned} E[x] =& E[Wz+\mu+\varepsilon]=\mu \\ cov[x] =& E[(x-E[x])(x-E[x])^T] \\ =& E[(Wz+\varepsilon)(Wz+\varepsilon)^T] \\ =& E[Wzz^TW^T+\varepsilon z^TW^T+Wz\varepsilon^T+\varepsilon\varepsilon^T] \\ =& WIW^T\cdot D(z) +D(\varepsilon) \\ =& WW^T + \sigma^2 I \end{aligned}

其中:zz 和 ε\varepsilon 是独立的。E(z⋅εT)=E(z)E(ε)=0E(z\cdot \varepsilon^T) = E(z)E(\varepsilon)=0

也可以直接利用方差的性质:

Var[x]=Var[Wz+μ+ε]=Var[Wz]+Var[ε]=W⋅I⋅WT+σ2I\begin{aligned} Var[x] = & Var[Wz+\mu+\varepsilon]\\ = & Var[Wz]+Var[\varepsilon] \\ = & W\cdot I \cdot W^T + \sigma^2I \end{aligned}

对于求解p(z∣x)p(z|x)比较难:

首先联合概率分布的PDF:

性质:

xb⋅a=xb−ΣbaΣaa−1xaμb⋅a=μb−ΣbaΣaa−1μaΣbb⋅a=Σbb−ΣbaΣaa−1Σabxb⋅a∼N(μb⋅a,Σbb⋅a)\begin{aligned} x_{b\cdot a} = & x_b -\Sigma_{ba}\Sigma_{aa}^{-1}x_a \\ \mu_{b\cdot a} = & \mu_b - \Sigma_{ba}\Sigma_{aa}^{-1}\mu_a \\ \Sigma_{bb\cdot a}= & \Sigma_{bb} - \Sigma_{ba}\Sigma_{aa}^{-1}\Sigma_{ab} \\ x_{b\cdot a} \sim & N(\mu_{b\cdot a},\Sigma_{bb\cdot a}) \end{aligned}

又:xb=xb⋅a+ΣbaΣaa−1xax_b = x_{b\cdot a} + \Sigma_{ba}\Sigma_{aa}^{-1}x_a

E[xb∣xa]=E[xb⋅a]+ΣbaΣaa−1xa=μba+ΣbaΣaa−1xa=μb+ΣbaΣaa−1(xa−μa)Var[xb∣xa]=Var[xb⋅a]+0=Σbb⋅a\begin{aligned} E[x_b|x_a] = &E[x_{b\cdot a }]+ \Sigma_{ba}\Sigma_{aa}^{-1}x_a \\ = &\mu_{ba} + \Sigma_{ba}\Sigma_{aa}^{-1}x_a \\ = &\mu_b + \Sigma_{ba}\Sigma_{aa}^{-1}(x_a-\mu_a) \\ Var[x_b|x_a] = & Var[x_{b\cdot a}]+0 = \Sigma_{bb\cdot a} \end{aligned}

上面介绍完性质:直接套用

(xz)∼N([μ0][WWT+σ2IWWI])\left( \begin{array}{c} x\\ z\\ \end{array} \right) \sim N\left( \begin{matrix} \left[ \begin{array}{c} \mu\\ 0\\ \end{array} \right]& \left[ \begin{matrix} WW^T+\sigma ^2I& W\\ W& I\\ \end{matrix} \right]\\ \end{matrix} \right)

其中:

cov(x,z)=E[(x−μ)(z−0)T]=E[(Wz+ε)zT]=E[WzzT]+E[ε⋅zT]=W⋅I=W\begin{aligned} cov(x,z) =& E[(x-\mu)(z-0)^T] \\ =& E[(Wz+\varepsilon)z^T] \\ =& E[Wzz^T]+E[\varepsilon\cdot z^T] \\ =& W \cdot I = W \end{aligned}

白板书推导:

p(z∣x)∼N(WT(WWT+σ2I)−1(x−μ),I−WT(WWT+σ2I)−1W)p(z|x) \sim N(W^T(WW^T+\sigma^2I)^{-1}(x-\mu),I-W^T(WW^T+\sigma^2I)^{-1}W)

PRML:

M=WTW+σ2IM = W^TW + \sigma^2I

P(z∣x)∼N(z∣M−1WT(x−μ),σ2M−1)P(z|x) \sim N(z|M^{-1}W^T(x-\mu),\sigma^2M^{-1})

根据矩阵的求逆公式:

(P−1+BTR−1B)−1BTR−1=PBT(BPBT+R)−1(P^{-1}+B^TR^{-1}B)^{-1}B^TR^{-1} = PB^T(BPB^T+R)^{-1}

可以证明上面白板书推导出的公式和PRML给出的公式是等价的。

EM算法

其中需要估计的参数是:W,μ,σ2W,\mu,\sigma^2

Likelihood

lnp(X∣W,μ,σ2)=∑n=1Nlnp(xn∣W,μ,σ2)=−ND2ln(2π)−N2ln∣Σ∣−12∑n=1N(xn−μ)TΣ−1(xn−μ)=−N2{Dln(2π)+ln∣Σ∣+Tr(Σ−1S}\begin{aligned} lnp({X}|W,\mu,\sigma^2) = & \sum_{n=1}^N lnp(x_n|W,\mu,\sigma^2)\\ = & -\frac{ND}{2}ln(2\pi) - \frac{N}{2}ln|\Sigma|-\frac{1}{2}\sum_{n=1}^N (x_n-\mu)^T\Sigma^{-1}(x_n-\mu) \\ = & -\frac{N}{2}\{ Dln(2\pi)+ln|\Sigma|+Tr(\Sigma^{-1}S\} \end{aligned}

常规:MLE求极值能得到近似封闭解

Joint Likelihood

lnp(X,Z∣W,μ,σ2)=∑n=1N{lnp(xn∣zn)+lnp(zn)}E[lnp(x,z∣W,μ,σ2)]=−∑n=1N{D2ln(2πσ2)+12Tr(E[znznT])+12σ2∥xn−μ∥2−1σ2E[zn]TWT(xn−μ)+12σ2Tr(E[znZnT]WTW)+M2ln(2π)}\begin{aligned} lnp(X,Z|W,\mu,\sigma^2) = & \sum_{n=1}^N\{lnp(x_n|z_n)+lnp(z_n)\} \\ E[lnp(x,z|W,\mu,\sigma^2)] = & -\sum_{n=1}^N\{\frac{D}{2}ln(2\pi\sigma^2) +\frac{1}{2}Tr(E[z_nz_n^T])+ \\ &\frac{1}{2\sigma^2}\|x_n-\mu\|^2-\frac{1}{\sigma^2}{E[z_n]^TW^T(x_n-\mu)+\frac{1}{2\sigma^2}Tr(E[z_nZ_n^T]W^TW)+\frac{M}{2}ln(2\pi)}\} \end{aligned}

其中,涉及需要估计充分统计量,需要依赖后验概率

E步:

Ez∣x[zn]=M−1WT(xn−xˉ)Ez∣x[znznT]=cov[zn]+E[zn]E[zn]T=σ2M−1+E[zn]E[zn]T\begin{aligned} E_{z|x}[z_n] = & M^{-1}W^T(x_n-\bar{x}) \\ E_{z|x}[z_nz_n^T] = & cov[z_n] + E[z_n]E[z_n]^T \\ = & \sigma^2M^{-1}+E[z_n]E[z_n]^T \end{aligned}

M步:固定后验概率,即充分统计量固定(看作常数)

首先明确更新的变量为:σ2\sigma^2和WW

举例说明:∂Δ∂W\frac{\partial\Delta}{\partial W}

Δ=−∑n=1N{−1σ2E[zn]TWT(xn−μ)+12σ2Tr(E[znznT]WTW)}\Delta = -\sum_{n=1}^N\{-\frac{1}{\sigma^2}E[z_n]^TW^T(x_n-\mu)+\frac{1}{2\sigma^2}Tr(E[z_nz_n^T]W^TW)\}

为了方便求导,利用迹的性质:

Tr(ABC)=Tr(BCA)=Tr(CAB)Tr(ABC) = Tr(BCA) = Tr(CAB)

故上面公式中:

Tr(E[znznT]WTW)=Tr(WTWE[znznT])Tr(E[z_nz_n^T]W^TW) = Tr(W^TWE[z_nz_n^T])

拉格朗日求导:

∂Δ∂W=∑n=1N{−1σ2E[zn]T(xn−μ)+12σ22WE[znznT]}=0\frac{\partial\Delta}{\partial W} = \sum_{n=1}^N\{-\frac{1}{\sigma^2}E[z_n]^T(x_n-\mu)+\frac{1}{2\sigma^2}2WE[z_nz_n^T]\} = 0

可以推出:

Wnew=[∑n=1NE[zn]T(xn−μ)][∑n=1NE[znznT]]−1W_{new} = [\sum_{n=1}^NE[z_n]^T(x_n-\mu)][\sum_{n=1}^NE[z_nz_n^T]]^{-1}

同理可得:(这里具体推导省略)

σ^new=1ND∑n=1N{∥xn−xˉ∥−2E[zn]TWnewT(xn−xˉ)+Tr(E[znznT]WnewTWnew)}\hat{\sigma}_{new}=\frac{1}{ND}\sum_{n=1}^N\{\|x_n-\bar{x}\|-2E[z_n]^TW_{new}^T(x_n-\bar{x})+Tr(E[z_nz_n^T]W_{new}^TW_{new}) \}

文章作者: Jacky
文章链接: https://wangjs-jacky.github.io/2020/03/04/P-PCA/
版权声明: 本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来自 Jacky's blogs!
繁