目录
  1. 背景介绍
  2. 预备知识
    1. 基础知识
    2. 推导技巧
  3. 主成分分析原理(PCA)
    1. 最大投影方差角度
      1. 0. 预备知识 - 向量投影
      2. 1. 算法原理
      3. 2. 算法流程
    2. 最小重构原理
    3. 总结
  4. PCA 实践:
    1. 基础:SVD 奇异值分解
    2. 三种角度看PCA降维问题:
      1. 空间重构原理:
      2. 通过对中心化后的数据,求SVD奇异值分解,奇异值的平方即为特征值
      3. 主坐标分析法(PCoA)
  5. PCA代码实践
    1. 实例01:
      1. Python基础实现:
      2. sklearn调包:PCA
    2. 实例02:图像压缩
读书笔记《scikit-learn-机器学习常用算法原理及编程实战》第10章PCA

本篇内容主要来源于白板书推导

背景介绍

  • 过拟合
    • 增加Data
    • 正则化
    • 降维
      • 直接降维:特征选择
      • 线性降维:PCA、MDS
      • 非线性降维:流形LSOMAP、LLE
  • 维度灾难
    • 集合角度
    • 数据稀疏,且分布不均

预备知识

基础知识

  • 数据:

    x=(x1⋯xn)nxpT=(x1Tx2T⋮xnT)=(x11x12⋯x1px21x22⋯x2p⋮⋮⋮⋮xn×1xn×2⋯xn×p)x=\left(x_{1} \cdots x_{n}\right)_{n x p}^{T}=\left(\begin{array}{c} {x_{1}^{T}} \\ {x_{2}^{T}} \\ {\vdots} \\ {x_{n}^{T}} \end{array}\right)=\left(\begin{array}{ccc} {x_{11}} & {x_{12}} & {\cdots} & x_{1 p} \\ {x_{21}} & {x_{22}} & {\cdots} & x_{2 p} \\ {\vdots} & {\vdots} & {\vdots} & {\vdots}\\ {x_{n\times1}} & {x_{n \times 2}} & {\cdots} & x_{n\times p} \end{array}\right)

  • 期望:

    xˉ=12∑i=1Nxi\bar{x}=\frac{1}{2} \sum_{i=1}^{N} x_{i}

  • 方差:

    Sp×p=1N∑i=1N(xi−xˉ)⋅(xi−xˉ)TS_{p \times p}=\frac{1}{N} \sum_{i=1}^{N}\left(x_{i}-\bar{x}\right) \cdot\left(x_{i}-\bar{x}\right)^{T}

推导技巧

  • 技巧:

    xˉ=1N∑i=1Nxi=1N(x1,x2,…,xn)⋅(11⋮1)=1NxT⋅1n\bar{x}=\frac{1}{N} \sum_{i=1}^{N} x_{i}=\frac{1}{N}(x_1,x_2,\dots,x_n)\cdot \left(\begin{array}{l} {1} \\ {1} \\ {\vdots} \\ 1\\ \end{array}\right) = \frac{1}{N}x^T\cdot 1^n

    (x1−xˉ,x2−xˉ,…,xn−xˉ)=(x1,x2,…,xn)−xˉ⋅(1,1,…,1)=xT−1NxT⋅1N⋅(1N)T=xT(In−1N⋅1N⋅(1N)T)=xT⋅HN=H⋅x\begin{aligned} (x_1 - \bar{x},x_2- \bar{x},\dots,x_n- \bar{x}) & =(x_1,x_2,\dots,x_n)-\bar{x}\cdot (1,1,\dots,1)\\ & =x^T-\frac{1}{N}x^T\cdot 1_N \cdot (1_{N})^T \\& =x^T(I_n- \frac{1}{N}\cdot 1_N \cdot (1_N)^T)\\&=x^T\cdot H_N \\ & = H\cdot x \end{aligned}

    HH的性质:

    • 易证:HT=HH^T = H

    • H2=H⋅H=HH^2 = H \cdot H = H

      证明:

      H2=(In−1N1n⋅(1n)T)⋅(In−1N1n⋅(1n)T)T=In+1N21N1NT1N1NT−2N1N1NT=In−1N1N1NT=H\begin{aligned} H^2 & = (I_n-\frac{1}{N}1^n\cdot (1^n)^T)\cdot (I_n-\frac{1}{N}1^n\cdot (1^n)^T)^T \\ &= I_n + \frac{1}{N^2}1_N1_N^T1_N1_N^T - \frac{2}{N}1_N1_N^T \\ &= I_n - \frac{1}{N}1_N1_N^T = H \end{aligned}

      推广有:

      HN=HH^N = H

⭕️根据上面的技巧改写期望和方差公式:

xˉ=1NxT⋅1nSp×p=1NxTH⋅(xTH)T=1NxTHx\begin{aligned} \bar{x} &= \frac{1}{N}x^T\cdot 1^n \\ S_{p \times p} &= \frac{1}{N}x^TH\cdot(x^T H)^T=\frac{1}{N}x^THx \end{aligned}


主成分分析原理(PCA)

Principal Component Analysis

  • 一个中心

    • 原始特征空间的重构
  • 两个基本点

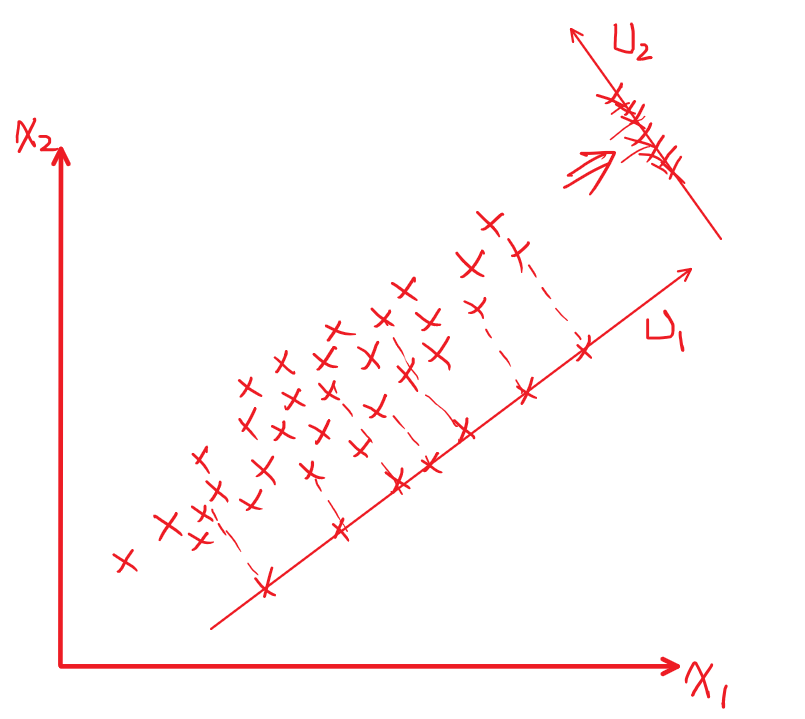
    • 最大投影方差角度

    • 最小重构距离【还原后的数据与原数据的差距最小】

最大投影方差角度

0. 预备知识 - 向量投影

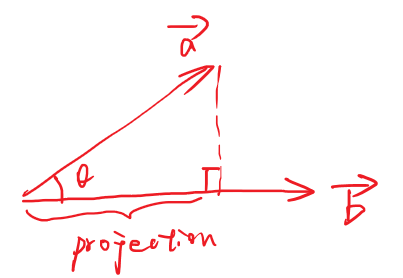
向量投影:

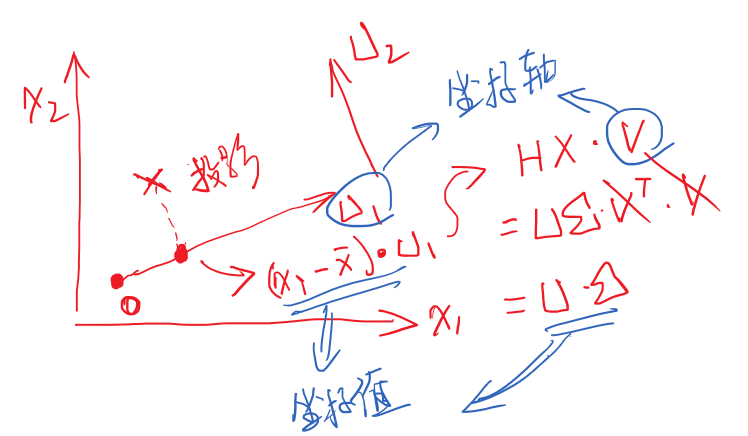
  • **坐标值:**与单位投影向量点积

    Projection=∣a∣⋅cosθProjection = |a|\cdot cos\theta

    若此时bˉ\bar{b}为单位向量,则Projection=a⋅b=∣a∣∣b∣cosθProjection = a \cdot b =|a||b|cos\theta

  • **坐标系:**投影向量

1. 算法原理

  • 将xx向量往最大投影向量ukˉ\bar{u_k}处投影:

(xiT⋅uk)uk(x_i^T \cdot u_k )u_k

  • 令投影后向量的方差最大

    • 投影后的向量为:(xiT⋅uk)uk(x_i^T \cdot u_k )u_k

    • 投影后的向量的方差:

    J=1N⋅∑i=1N((xi−xˉ)⋅uk)2=1N⋅∑i=1N((xi−xˉ)⋅uk)T⋅((xi−xˉ)⋅uk)=∑i=1N1NukT(xi−xˉ)(xi−xˉ)Tuk=ukT[∑i=1N1N(xi−xˉ)(xi−xˉ)T]uk=ukTSp×puk\begin{aligned} J &= \frac{1}{N}\cdot \sum_{i=1}^N((x_i-\bar{x}) \cdot u_k )^2 \\ &= \frac{1}{N}\cdot \sum_{i=1}^N ((x_i-\bar{x}) \cdot u_k )^T\cdot ((x_i-\bar{x}) \cdot u_k ) \\ & = \sum_{i=1}^N \frac{1}{N} u_k^T(x_i - \bar{x})(x_i - \bar{x})^T u_k \\ & = u_k^T [\sum_{i=1}^N \frac{1}{N}(x_i - \bar{x})(x_i - \bar{x})^T] u_k \\ & = u_k^T S_{p \times p} u_k \end{aligned}

    条件:∣uk∣=1|u_k|=1 ,也即ukT⋅uk=1u_k^T\cdot u_k =1

  • 拉格朗日函数法,求上面的极大值:

    L(uk,λ)=ukTSp×puk+λ⋅(1−ukT⋅uk)L(u_k,\lambda)= u_k^T S_{p \times p} u_k + \lambda \cdot (1 - u_k^T\cdot u_k)

    求导后等于0:

    ∂L∂uk=2⋅Sp×p⋅uk−λ⋅2⋅u1=0\frac{\partial L}{\partial u_k} = 2 \cdot S_{p \times p }\cdot u_k - \lambda \cdot 2 \cdot u_1 =0

    可得:

    S⋅uk=λ⋅ukS\cdot u_k = \lambda \cdot u_k

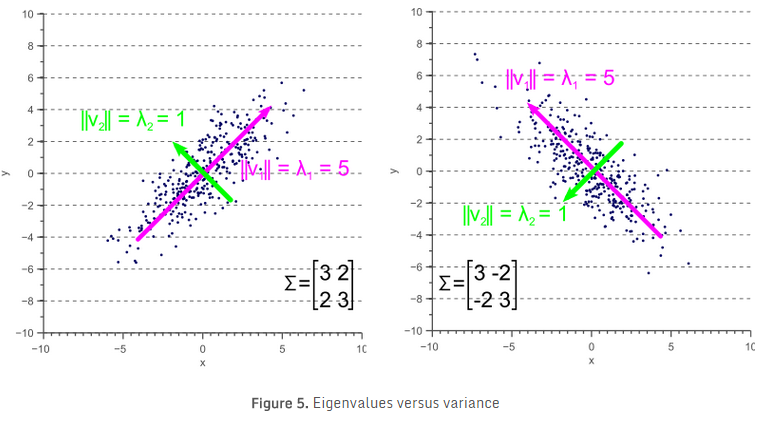
    综上可得,投影向量为方差矩阵Sp×pS_{p\times p}的特征向量。

2. 算法流程

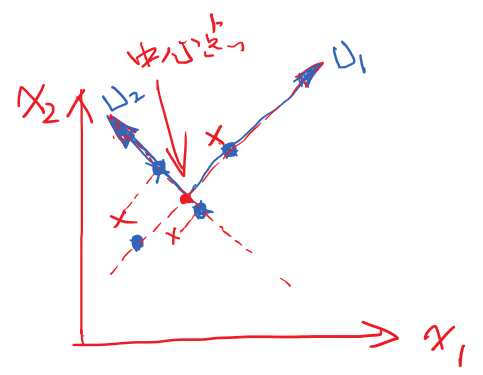
  • **步骤1:**数据中心化,即H⋅XH \cdot X ,根据需要归一化 – Normalized

  • 去中心化后的目的,让uku_k的原点正好穿过特征的中心。

  • **步骤2:**计算协方差矩阵

  • 步骤3:利用特征值分解可以得到特征向量。

  • 步骤4:根据特征向量构造投影矩阵

  • **步骤5:**根据投影矩阵,降维数据。

最小重构原理

  • 降维的思路:

    • 先利用方差矩阵Sp×pS_{p \times p }可以找到一组独立的基向量{u1,u2,…,up}\{u_1,u_2,\dots,u_p\}对应的特征值为 {λ1,λ2,…,λp}\{\lambda_1,\lambda_2,\dots,\lambda_p\}
    • 压缩降维,选择前qq个最大值的λ\lambda
  • 根据投影方向向量uku_k来重构原先的坐标xkx_k

    xi=∑k=1P(xiT⋅uk)⋅ukx_i = \sum_{k=1}^P (x_i^T \cdot u_k)\cdot u_k

    x^=∑k=1q(xiT⋅uk)⋅uk\hat{x}= \sum_{k=1}^q (x_i^T \cdot u_k)\cdot u_k

  • 最小重构代价:

    J=∑i=1N1N∥xi−xi^∥2=∑k=q+1pukTSukJ = \sum_{i=1}^N \frac{1}{N} \|x_i - \hat{x_i}\|^2 = \sum_{k=q+1}^p u_k^TS u_k

    同理要求:ukT⋅uk=1u_k^T\cdot u_k = 1

总结

最大投影方差等价于 最小重构原理

目的:从uku_k轴重构回去的损失最小

PCA 实践:

基础:SVD 奇异值分解

  • 公式:

    W=UΣVT=(λ1)u1⃗(v1⃗)T+(λ2)u2⃗(v2⃗)T\begin{aligned} W &= U\Sigma V^T \\ &= \sqrt(\lambda_1)\vec{u_1}(\vec{v_1})^T + \sqrt(\lambda_2)\vec{u_2}(\vec{v_2})^T \end{aligned}

上述公式只有两个特征值,说明原向量的维度是2,方差矩阵是S2×2S_{2\times 2} ,降维的话,直接舍弃其中的一个部分即可。现在的问题就是如何求以上的几个值?

  • 如何求解:λ\lambda 、uku_k 、vkv_k ?

    • 首先,我们可以对任何的矩阵(并非一定要方阵)进行奇异值分解,若想要将矩阵对角化求取特征值,必须要求方阵,而$W \cdot W^T 以及以及W^T\cdot W$一定是方阵。

    • W⋅WTW\cdot W^T

      W⋅WT=(UΣVT)(UΣVT)T=U(ΣTΣ)UT=U⋅D⋅UT\begin{aligned} W\cdot W^T &= (U\Sigma V^T)(U\Sigma V^T)^T \\ &= U (\Sigma^T\Sigma)U^T \\ &= U \cdot D \cdot U^T \\ \end{aligned}

    • WT⋅WW^T \cdot W

      WT⋅W=(UΣVT)T(UΣVT)=V(ΣTΣ)VT=V⋅D⋅VT\begin{aligned} W^T \cdot W &= (U\Sigma V^T)^T(U\Sigma V^T) \\ &= V (\Sigma^T\Sigma)V^T \\ &= V \cdot D \cdot V^T \\ \end{aligned}

    • 只要分别将原矩阵与自己的转置相乘,就可以得到对应的 特征值 和 特征向量

三种角度看PCA降维问题:

空间重构原理:

找到方差矩阵,进行特征值分解,对应的特征值向量,即为主方向【即可】

Sp×p=G⋅K⋅GTs.t.GTG=1S_{p \times p} = G \cdot K \cdot G^T \\ s.t. G^TG = 1

​ 其中KK值为:

K = [k1k2⋱kp]k1≥k2≥k3≥⋯≥kp\begin{array}{c} K\ =\ \left[ \begin{matrix} k_1& & & \\ & k_2& & \\ & & \ddots& \\ & & & k_p\\ \end{matrix} \right]\\ k_1\ge k_2\ge k_3\ge \cdots \ge k_p\\ \end{array}

  • 如何还原?

    • 选择前qq个最大的K值,所对应的特征向量uku_k即可。

    • 有了最大的投影向量,我们直接往最大方向投影就ok了!

      无损失:

      xi=∑k=1P(xiT⋅uk)⋅ukx_i = \sum_{k=1}^P (x_i^T \cdot u_k)\cdot u_k

      少选几个特征:

      x^=∑k=1q(xiT⋅uk)⋅uk\hat{x}= \sum_{k=1}^q (x_i^T \cdot u_k)\cdot u_k

通过对中心化后的数据,求SVD奇异值分解,奇异值的平方即为特征值

这里直接对中心化后的数据进行SVD分解

  • 原理:

HX=UΣVT=(λ1)u1⃗(v1⃗)T+(λ2)u2⃗(v2⃗)T+⋯\begin{aligned} H X&= U\Sigma V^T \\ &= \sqrt(\lambda_1)\vec{u_1}(\vec{v_1})^T + \sqrt(\lambda_2)\vec{u_2}(\vec{v_2})^T + \cdots \end{aligned}

  • 如何计算

    • HX(HX)THX(HX)^T 进行特征对角化处理 ,可以求得:λ\lambda、u⃗\vec{u}
    • (HX)THX(HX)^THX 进行特征对角化处理,可以求得:λ\lambda、v⃗\vec{v}
  • 如何还原?

    取前k项即可,取得越多越近似!

主坐标分析法(PCoA)

Principle coordinate analysisPrinciple\ coordinate\ analysis

背景说明:
若此时$S_{p \times p} $中维度P远远大于样本的个数 NN 时,【如图片处理,维度都是几万维】求解Sp×pS_{p \times p}还是比较困难的。有没有解决简单的方法可以跳过对方差的计算?当然有!

  • 前两个方法的缺点:

    • 当$S_{p \times p} $的维度太大的时候,计算效率太低

    注:SVD分解中,其实也蕴含着对方差的计算,如:对xTHTHxx^TH^THx进行特征分解。

    Sp×p=1NxTH⋅(xTH)T=1NxTHTHx S_{p \times p} = \frac{1}{N}x^TH\cdot(x^T H)^T=\frac{1}{N}x^TH^THx

  • PCA中的结果:

    第一步:我们在PCA中的目的,就是为了找到一组能使方差最大化的特征向量。

    第二步:将中心化后的特征HXHX直接投到这组新的坐标下,即与特征向量vv进行点积,在新坐标系vkv_k下的坐标值 UΣU \Sigma。公式如下:

    HX⋅V=UΣVTV=UΣHX\cdot V = U \Sigma V^TV=U\Sigma

    然后,,坐标值为UΣU\Sigma。

  • 若直接对 HX(HX)THX(HX)^T 进行特征对角化处理 ,可以求得:Σ\Sigma 和 UU

    将两者相乘,就直接得到了我们在新坐标系下的坐标。

PCA代码实践

实例01:

A = [3200023000450005800012000]A\ =\ \left[ \begin{matrix} 3& 2000\\ 2& 3000\\ 4& 5000\\ 5& 8000\\ 1& 2000\\ \end{matrix} \right]

Python基础实现:

  • 数据预处理,【数据归一化,数据缩放】

    中心化公式:H⋅XH\cdot X

    # 数据归一化
    mean = np.mean(A, axis=0)
    norm = A - mean
    # 数据缩放
    scope = np.max(norm, axis=0) - np.min(norm, axis=0)
    norm = norm / scope
  • 奇异值分解:

    H⋅X=UΣVT=(λ1)u1⃗(v1⃗)T+(λ2)u2⃗(v2⃗)T\begin{aligned} H\cdot X &= U\Sigma V^T \\ &= \sqrt(\lambda_1)\vec{u_1}(\vec{v_1})^T + \sqrt(\lambda_2)\vec{u_2}(\vec{v_2})^T \end{aligned}

    U, S, V = np.linalg.svd(np.dot(norm.T, norm))
    U

    array([[-0.67710949, -0.73588229],
    [-0.73588229, 0.67710949]])
  • 选取特征矩阵的第一个列来构造

    R^=(λ1)u1⃗(v1⃗)T\hat{R} = \sqrt(\lambda_1)\vec{u_1}(\vec{v_1})^T

    U_reduce = U[:, 0].reshape(2,1)
    R = np.dot(norm, U_reduce)
    R

    array([[ 0.2452941 ],
    [ 0.29192442],
    [-0.29192442],
    [-0.82914294],
    [ 0.58384884]])
  • 还原:

    投影公式:

    Z=HX⋅VZ = HX\cdot V

    说明:V是一个正交矩阵,有:V⋅VT=V⋅V−1=EV \cdot V^T = V \cdot V^{-1}=E

    还原公式:

    H⋅X=Z⋅V−1=Z⋅VTH\cdot X = Z \cdot V^{-1} = Z \cdot V^T

    Z = np.dot(R, U_reduce.T)
    Z

    array([[-0.16609096, -0.18050758],
    [-0.19766479, -0.21482201],
    [ 0.19766479, 0.21482201],
    [ 0.56142055, 0.6101516 ],
    [-0.39532959, -0.42964402]])
  • 反中心化和反数据放缩

    # 反数据放缩 + 反中心化
    np.multiply(Z, scope) + mean

sklearn调包:PCA

  • 调包实践

    from sklearn.decomposition import PCA
    from sklearn.pipeline import Pipeline
    from sklearn.preprocessing import MinMaxScaler

    def std_PCA(**argv):
    scaler = MinMaxScaler()
    pca = PCA(**argv)
    pipeline = Pipeline([('scaler', scaler),
    ('pca', pca)])
    return pipeline

    pca = std_PCA(n_components=1)
    R2 = pca.fit_transform(A)
    R2

    array([[-0.2452941 ],
    [-0.29192442],
    [ 0.29192442],
    [ 0.82914294],
    [-0.58384884]])
  • 反放缩和反归一化,之前是np.multiply(Z, scope) + mean

    # 调包反数据预处理
    pca.inverse_transform(R2)

实例02:图像压缩

文章作者: Jacky
文章链接: https://wangjs-jacky.github.io/2019/12/27/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0%E3%80%8Ascikit-learn-%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0%E5%B8%B8%E7%94%A8%E7%AE%97%E6%B3%95%E5%8E%9F%E7%90%86%E5%8F%8A%E7%BC%96%E7%A8%8B%E5%AE%9E%E6%88%98%E3%80%8B%E7%AC%AC10%E7%AB%A0PCA/
版权声明: 本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来自 Jacky's blogs!
繁